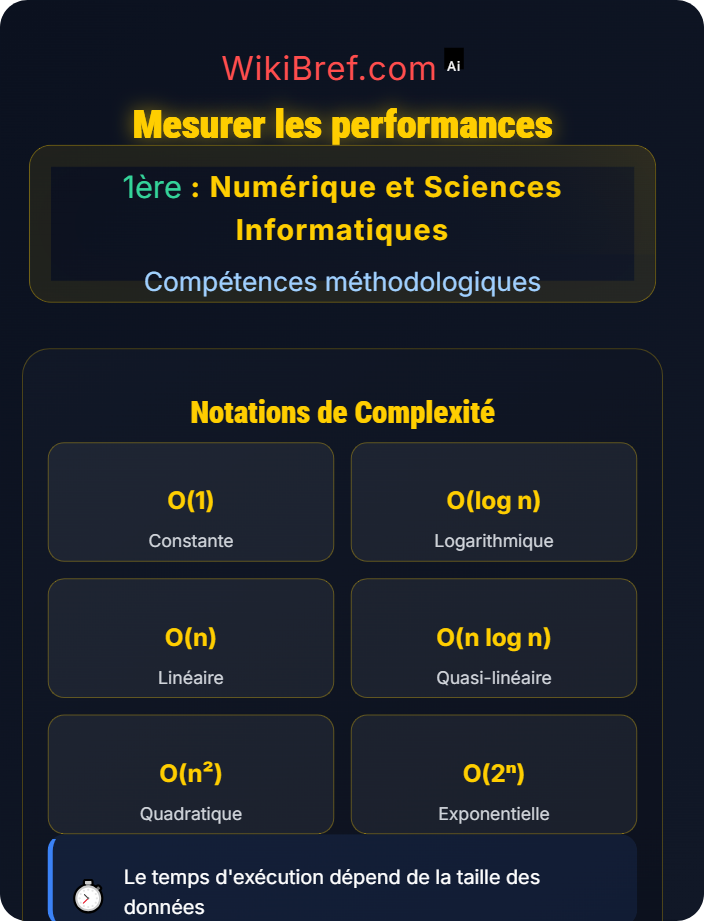
- Temps d'exécution : Durée pour compléter une tâche
- Utilisation mémoire : Quantité de RAM utilisée
- Complexité algorithmique : O(n), O(n²), O(log n), etc.
- Utilisation CPU : Charge processeur pendant l'exécution
Problème : Analyser la complexité d'un algorithme de recherche linéaire
- Identifier les opérations élémentaires
- Compter le nombre d'opérations en fonction de la taille
- Déterminer la complexité dans le pire des cas
- Comparer avec la complexité théorique
FONCTION RechercheLineaire(tableau, element) : Entier
  POUR i DE 0 A LONGUEUR(tableau) - 1 FAIRE
    SI tableau[i] = element ALORS
      RETOURNER i
    FIN SI
  FIN POUR
  RETOURNER -1
FINOpérations dans la boucle :
• Comparaison tableau[i] = element : 1 opération
• Incrémentation de i : 1 opération
• Comparaison de i avec la taille : 1 opération
Dans le pire cas : L'élément n'est pas dans le tableau, la boucle s'exécute n fois
Nombre d'opérations : 3n (dans le pire cas)
Complexité temporelle : O(n)
Complexité spatiale : O(1) - pas de mémoire supplémentaire
Conclusion : Algorithme linéaire en temps, constant en espace
L'algorithme de recherche linéaire a une complexité linéaire dans le pire des cas, ce qui est acceptable pour des petites tailles mais inefficace pour des grandes données.
• Compter les opérations dominantes : Boucles, comparaisons
• Identifier le pire cas : Situation où l'algorithme met le plus de temps
• Simplifier l'expression : Garder le terme dominant
Problème : Comparer les performances de deux algorithmes de tri
FONCTION TriInsertion(tableau) : Tableau
  POUR i DE 1 A LONGUEUR(tableau) - 1 FAIRE
    cle ← tableau[i]
    j ← i - 1
    TANT QUE j ≥ 0 ET tableau[j] > cle FAIRE
      tableau[j + 1] ← tableau[j]
      j ← j - 1
    FIN TANT QUE
    tableau[j + 1] ← cle
  FIN POUR
  RETOURNER tableau
FIN

FONCTION TriRapide(tableau) : Tableau
  SI LONGUEUR(tableau) ≤ 1 ALORS
    RETOURNER tableau
  FIN SI

  pivot ← tableau[LONGUEUR(tableau) DIV 2]
  gauche ← [x POUR x IN tableau SI x < pivot]
  milieu ← [x POUR x IN tableau SI x = pivot]
  droite ← [x POUR x IN tableau SI x > pivot]

  RETOURNER TriRapide(gauche) + milieu + TriRapide(droite)
FIN| Taille | TriInsertion | TriRapide | Avantage |
|---|---|---|---|
| 100 | 0.002s | 0.001s | TriRapide |
| 1,000 | 0.150s | 0.008s | TriRapide |
| 10,000 | 14.5s | 0.09s | TriRapide |
| 100,000 | ~24min | 1.2s | TriRapide |
TriInsertion : O(n²) - Performances dégradées avec la taille
TriRapide : O(n log n) en moyenne - Beaucoup plus efficace
Point de bascule : Vers 1000 éléments, TriRapide devient nettement plus rapide
Conclusion : Pour de grandes données, TriRapide est préférable
Malgré sa complexité théorique supérieure dans le pire des cas, le TriRapide est beaucoup plus efficace en pratique pour des données de taille moyenne à grande.
• Utiliser des jeux de test réalistes : Données représentatives
• Mesurer plusieurs fois : Prendre la moyenne pour lisser les variations
• Comparer avec la complexité théorique : Vérifier la cohérence
Problème : Analyser l'utilisation mémoire d'une fonction récursive
FONCTION FactorielleRec(n) : Entier
  SI n = 0 OU n = 1 ALORS
    RETOURNER 1
  SINON
    RETOURNER n * FactorielleRec(n - 1)
  FIN SI
FINVariables locales par appel : 1 variable entière (n)
Profondeur de récursion : n niveaux pour Factorielle(n)
Mémoire supplémentaire : O(n) pour la pile d'appels
Comparaison avec version itérative : O(1) d'espace supplémentaire
FONCTION FactorielleIter(n) : Entier
  resultat ← 1
  POUR i DE 2 A n FAIRE
    resultat ← resultat * i
  FIN POUR
  RETOURNER resultat
FIN

// Comparaison des performances
// FactorielleRec(1000): ~8KB de pile, risque de dépassement
// FactorielleIter(1000): ~100B, très efficace en mémoire| Version | Complexité temporelle | Complexité spatiale | Risque |
|---|---|---|---|
| Récursive | O(n) | O(n) | Dépassement de pile |
| Itérative | O(n) | O(1) | Aucun |
La version itérative est préférable en termes de consommation mémoire, même si les deux versions ont la même complexité temporelle.
• Évaluer la consommation spatiale : Variables, structures de données
• Considérer la récursion : Impact sur la pile d'appels
• Optimiser quand possible : Remplacer la récursion par l'itération
Problème : Optimiser une fonction récursive avec mémorisation
FONCTION Fibonacci(n) : Entier
  SI n = 0 OU n = 1 ALORS
    RETOURNER n
  SINON
    RETOURNER Fibonacci(n - 1) + Fibonacci(n - 2)
  FIN SI
FIN

// Problème: Fibonacci(5) calcule Fibonacci(3) plusieurs fois!Complexité temporelle : O(2^n) - Extrêmement inefficace
Calcul de Fibonacci(10) : 177 appels récursifs
Calcul de Fibonacci(30) : 2,692,537 appels récursifs!
Problème : Les mêmes sous-problèmes sont recalculés plusieurs fois
FONCTION FibonacciMemo(n, memo={}) : Entier
  SI n IN memo ALORS
    RETOURNER memo[n]
  FIN SI

  SI n = 0 OU n = 1 ALORS
    resultat ← n
  SINON
    resultat ← FibonacciMemo(n - 1, memo) + FibonacciMemo(n - 2, memo)
  FIN SI

  memo[n] ← resultat
  RETOURNER resultat
FIN

// Résultat: Fibonacci(30) = 832040, mais avec seulement 30 appels!| n | Fibonacci naïf | Fibonacci mémorisé | Gain |
|---|---|---|---|
| 10 | 177 appels | 10 appels | 17.7x |
| 20 | 21,891 appels | 20 appels | 1,095x |
| 30 | 2,692,537 appels | 30 appels | 89,751x |
La mémorisation transforme radicalement les performances d'une fonction récursive mal conçue, passant d'une complexité exponentielle à une complexité linéaire.
• Identifier les sous-problèmes répétés : Rechercher les calculs redondants
• Utiliser la mémorisation : Stocker les résultats intermédiaires
• Transformer en programmation dynamique : Approche bottom-up
Problème : Comparer différentes implémentations d'une même fonctionnalité
FONCTION CompterOccurrences_v1(chaine, lettre) : Entier
  compteur ← 0
  POUR caractere IN chaine FAIRE
    SI caractere = lettre ALORS
      compteur ← compteur + 1
    FIN SI
  FIN POUR
  RETOURNER compteur
FIN

FONCTION CompterOccurrences_v2(chaine, lettre) : Entier
  RETOURNER LONGUEUR(FILTRER c IN chaine SI c = lettre)
FIN

FONCTION CompterOccurrences_v3(chaine, lettre) : Entier
  RETOURNER CHAINE_OCCURRENCES(chaine, lettre)  // Fonction native
FIN| Implémentation | Temps (ms) | Complexité | Clarté | Recommandation |
|---|---|---|---|---|
| v1 - Boucle | 45.2ms | O(n) | Très claire | Bonne pour apprentissage |
| v2 - Filtrage | 38.7ms | O(n) | Assez claire | Élégante et fonctionnelle |
| v3 - Native | 8.3ms | O(n) | Moins claire | Meilleure performance |
Implémentation v1 : Claire mais plus lente à cause de la boucle explicite
Implémentation v2 : Élégante mais crée une nouvelle liste intermédiaire
Implémentation v3 : Très rapide car optimisée en interne (langage bas niveau)
Compromis : Clarté vs Performance vs Lisibilité
Pour l'apprentissage : Version 1 (explicite)
Pour le code de production : Version 3 (native)
Pour le code fonctionnel : Version 2 (élégante)
Conclusion : Le choix dépend du contexte et des priorités
La comparaison montre que l'implémentation native est 5 fois plus rapide que la version manuelle, soulignant l'importance de bien choisir ses outils selon le contexte.
• Tester dans des conditions réalistes : Données représentatives
• Considérer plusieurs critères : Performance, lisibilité, maintenance
• Documenter les résultats : Pour référence future
- Chronométrage : Mesurer le temps d'exécution
- Profilage mémoire : Analyser l'utilisation de la RAM
- Complexité théorique : Analyse algorithmique
- Test de charge : Évaluer avec des volumes croissants
- La complexité théorique ne reflète pas toujours les performances réelles
- Un algorithme optimal en temps peut utiliser trop de mémoire
- Les performances peuvent varier selon les données d'entrée
- Il faut toujours valider que l'optimisation ne casse pas la logique
- Équilibre : Chercher le bon compromis entre performance, lisibilité et maintenance
- Contexte : Adapter les mesures au contexte d'utilisation
- Mesure objective : Utiliser des critères mesurables pour comparer les solutions
- Amélioration continue : Réévaluer régulièrement les performances des solutions existantes